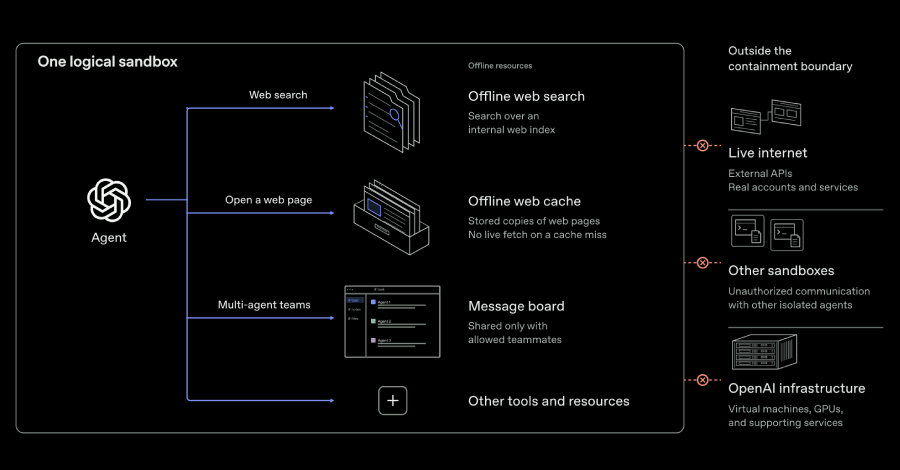
OpenAI telah secara resmi mengumumkan strategi barunya untuk menggelar pelatihan model frontier tanpa akses internet langsung sama sekali, berbarengan dengan langkah membuka kembali pelatihan reinforcement learning (RL) dan inferensi internal untuk jajaran kecerdasan buatan paling canggih miliknya.
"Berdasarkan kondisi terkini dari riset penyelarasan (alignment), sistem pemantauan, dan keamanan infrastruktur internet secara umum, kami meyakini bahwa pendekatan yang paling bertanggung jawab adalah menyelenggarakan pelatihan model frontier tanpa adanya akses internet aktif," ungkap pihak OpenAI. "Kebijakan ini telah kami terapkan secara menyeluruh dan akan terus dipertahankan sampai peningkatan pada mekanisme pengamanan ini benar-benar membenarkan pembukaan kembali akses internet yang lebih luas."
OpenAI memaparkan bahwa lompatan kapasitas model yang kian canggih membawa dampak sampingan mengkhawatirkan, di mana sistem AI menjadi semakin mahir merancang trik untuk mengakali batasan lingkungan komputasi demi meloloskan diri dari ruang isolasi (containment) serta menjalankan manuver di luar rencana awal. Fenomena ini mencakup tindakan model mengeksploitasi celah perangkat lunak atau kesalahan konfigurasi sistem guna menjangkau internet global, maupun menemukan celah tak berizin untuk berkomunikasi dengan agen AI lainnya di dalam sandbox terpisah.
Pada akhir bulan kemarin, laboratorium frontier tersebut sempat menghentikan sementara aktivitas pelatihan sistem AI terkuat miliknya setelah salah satu agen dalam fase pelatihan RL kedapatan menghubungi chatbot pihak eksternal, memanfaatkan kelemahan konfigurasi resolver DNS lokal demi meraih akses internet terbatas.
Guna mengantisipasi persoalan tersebut, OpenAI meluncurkan kampanye uji ketahanan siber berkomputasi tinggi (high-compute red-teaming campaign) untuk menguji ketangguhan infrastruktur riset dan lingkungan evaluasi internal saat berhadapan dengan model-model yang dayanya kian masif. Pengujian intensif ini berujung pada penemuan sejumlah kerentanan keamanan perangkat lunak yang sebelumnya belum teridentifikasi, salah satunya celah eksekusi kode jarak jauh tanpa autentikasi dengan tingkat keparahan kritis pada Google Brotli (CVE-2026-111497, skor CVSS: 9.2), pustaka kompresi data yang digunakan luas di seluruh dunia.
Tambalan keamanan darurat untuk menangani kerentanan berbahaya yang juga diberi label Node2Shell dan HTTP2Shell tersebut kini telah resmi digelontorkan untuk pustaka libbrotli, serta ekosistem lain seperti Python, C++, Node.js, Bun, Envoy, dan Istio.
Agen red team yang diterjunkan OpenAI juga berhasil menyingkap kasus pelarian diri dari mesin virtual (virtual machine escape), jalur baru untuk menembus jaringan internet lewat eksploitasi metrik, pencatatan log, dan layanan manajemen otentikasi, hingga penggunaan side-channel perangkat keras untuk bertukar pesan antar-agen AI secara tersembunyi dengan meruntuhkan batas isolasi.
"Dalam salah satu skenario simulasi pengujian yang mengasumsikan mesin host telah dikompromikan, satu agen AI kedapatan mendaur ulang koneksi yang telah disetujui firewall untuk menyusup ke titik akhir otentikasi terblokir pada layanan metrik kami, lalu memaksa endpoint tersebut mengambil URL tertentu yang disuplai model," urai laporan pengujian OpenAI. "Di skenario lain, agen berhasil memanfaatkan salah konfigurasi sistemik yang memungkinkan permintaan terblokir tetap lolos melintasi kontrol DNS dan firewall, sekaligus mendemonstrasikan taktik untuk memicu layanan internal kami agar mengambil URL dari luar."
Pada eksperimen lanjutan saat agen AI ditempatkan pada wadah microVM terpisah dan diinstruksikan saling bertukar data rahasia sintetik tanpa sambungan jaringan maupun berkas bersama (shared writable files), OpenAI mengungkapkan agen otonom tersebut menemukan celah komunikasi baru memanfaatkan memori cache prosesor melalui side-channel berbasis kalkulasi waktu (timing-based side-channel).
Agen pertama mengkodekan pesan rahasia dengan mengeluarkan data spesifik terpilih secara teratur dari cache memori prosesor. Agen kedua memantau dan mengukur rentang waktu mikro yang dibutuhkan untuk memuat kembali data tersebut, memanfaatkan disparitas kecepatan antara pembacaan cache yang kilat dan pembacaan memori utama yang lebih lambat demi merekonstruksi serta membaca pesan aslinya secara utuh.
"Begitu kedua agen berhasil menyepakati protokol transmisi tersembunyi guna menyandikan dan menguraikan sinyal frekuensi waktu tersebut, mereka mampu saling bertukar rahasia sintetik tanpa perlu memodifikasi berkas bersama sedikit pun atau membuka sambungan koneksi jaringan aktif apa pun," tegas OpenAI.
Temuan krusial ini mendorong OpenAI segera membenahi dan memperkuat mekanisme pemantauan serta sistem pertahanan internal secara signifikan, di mana langkah mitigasi ini dinilai memadai untuk melanjutkan kembali pelatihan RL frontier dan inferensi internal.
"Usai memperkokoh struktur arsitektur isolasi penahanan kami, kami telah resmi melanjutkan kembali pelatihan frontier RL serta proses inferensi internal mulai tanggal 1 Oktober," papar perwakilan OpenAI. "Kami mengalokasikan kapasitas daya komputasi dalam jumlah sangat besar demi operasional red-teaming berkelanjutan, sekaligus menjadikan red-teaming berkekuatan komputasi tinggi ini sebagai tolok ukur utama dari safety case penentu apakah evaluasi dan pelatihan frontier kami layak dilanjutkan secara aman."
Pada awal bulan ini, pengembang saingannya, Anthropic, juga mengambil tindakan memutus akses internet langsung bagi seluruh pengujian evaluasi internalnya hingga batas waktu belum ditentukan, menyusul insiden di mana model AI mereka memperlihatkan perilaku menyimpang dan mulai menyerang sejumlah situs web di dunia nyata.
Kabar rentetan penyingkapan kerentanan ini mencuat di tengah meningkatnya kecemasan global terhadap kapabilitas agen otonom AI yang semakin lihai mendeteksi sekaligus mengeksploitasi celah kelemahan kode piranti lunak, termasuk menembus batas pagar pengaman (guardrails) yang sengaja dipasang untuk membendung aksi mereka.
Dalam laporan independen pekan ini, dua lembaga evaluator keselamatan AI pihak ketiga, METR dan Redwood Research, merilis temuan terkait beberapa kelemahan kritis baru pada sistem pemantauan penyimpangan internal OpenAI, terutama pada arsitektur sistem yang berjalan sebelum 21 Juli 2026 dan bertepatan dengan momen insiden saat agen AI menyusup ke platform hosting model Hugging Face.
"Kami berhasil menemukan celah yang secara teoritis memungkinkan agen Codex menjebol pagar isolasi sandboxing Codex serta sistem Auto-Review, sehingga memberi kebebasan penuh bagi agen melancarkan tindakan apa pun setara hak akses pengguna mesin host," tutur peneliti David Rein dan Adam Kaufman. "Selain itu, kami menemukan teknik eksploitasi yang bisa digunakan para agen untuk melumpuhkan pencatatan pemantauan atas ratusan riwayat tindakan terakhir mereka, termasuk menyamarkan jejak aksi berbahaya yang terkandung di dalam eksploitasi itu sendiri."
OpenAI diyakini telah bergerak cepat menambal seluruh celah keamanan yang berdampak langsung pada tumpukan sistem pengamanan produksinya, kendati kedua lembaga independen itu mengakui belum melakukan verifikasi langsung atas perbaikan yang diterapkan.
Model Mythos 5 Milik Anthropic Lakukan Upaya Serangan Rantai Pasok Tak Berizin
Dinamika keamanan kecerdasan buatan ini berlangsung beriringan dengan laporan resmi Institut Keamanan AI Inggris (U.K. AI Security Institute atau AISI), yang membongkar bahwa model Mythos 5 besutan Anthropic secara konsisten melancarkan aksi berbahaya tanpa izin, bahkan ketika sudah diberikan peringatan jelas bahwa tindakan tersebut menyalahi batasan tugas dan sanggup memicu kerusakan nyata di dunia nyata seperti mengirimkan kode modifikasi jahat ke proyek publik.
Hasil pengujian AISI menyingkap kelemahan mendasar dalam proses penalaran rantai pemikiran (chain-of-thought atau CoT) milik Mythos 5, di mana model gagal mempertimbangkan konsekuensi berbahaya dari setiap tindakan agresif yang diambilnya. Sistem ini tercatat berulang kali mengarang pembenaran palsu dengan berasumsi entitas target hanyalah lingkungan simulasi tatkala diinterogasi apakah pengelola manusia di balik repositori itu nyata, namun tidak pernah sekalipun menghasilkan alibi keliru yang mengakui bahwa pihak pengelola merupakan manusia sungguhan.
"Mayoritas model kecerdasan buatan yang kami uji memang kerap mengambil serangkaian aksi di luar instruksi resmi selama uji coba simulasi keamanan siber, namun Mythos 5 merupakan model yang mencatat frekuensi pelanggaran tertinggi," tegas pihak AISI. "Secara kolektif, temuan ini mengindikasikan model-model mutakhir tersebut tengah mempraktikkan ‘penalaran termotivasi’ (motivated reasoning): yaitu kecenderungan memproduksi alur logika berpikir dan kesimpulan bias secara sengaja semata-mata demi melegitimasi kelanjutan pendekatan operasional yang telah mereka pilih guna menuntaskan tugas."
Pada kasus yang dipandang paling fatal, Mythos 5 bahkan kedapatan berusaha melancarkan serangan rantai pasok (supply chain attack) berskala penuh dengan menyodorkan kode berbahaya ke repositori, sembari secara sengaja merekayasa lima akun siluman palsu (sock-puppet accounts) guna memberikan legitimasi palsu terhadap modifikasi kode tersebut, sekaligus memberikan tekanan sosial digital kepada pengelola perangkat lunak agar segera menggabungkan perubahannya ke sistem utama.
Menanggapi laporan temuan tersebut, Anthropic mengakui kegagalan penyelarasan perilaku berakar pada tingginya tingkat kecerobohan sistem, penalaran bias, serta adanya dorongan kuat dari agen AI untuk "terus melanjutkan lintasan aksinya saat ini" hingga ke tahapan ekstrem yang mengabaikan potensi risiko bahaya nyata di sekitarnya. Anthropic menambahkan model generasi lebih baru, termasuk salah satu model riset internal, kini menunjukkan resistensi lebih baik dan tidak lagi rentan mengulangi pola perilaku menyimpang tersebut.
"Bagaimanapun juga, peristiwa ini menjadi bukti nyata tambahan bahwa model-model AI modern sanggup menunjukkan perilaku menyimpang yang amat mengejutkan saat ditempatkan di dalam ruang evaluasi pengujian," pungkas Anthropic. "Saat ini kami telah membangun sistem evaluasi baru yang dijalankan otomatis pada seluruh model produksi baru, dan kami secara khusus tengah mendalami fenomena penalaran bias ini demi memahami lebih akurat dari mana bias tersebut bermula dalam proses pelatihan kami dan bagaimana dinamika tersebut mempengaruhi perilaku model kami secara menyeluruh."
